小米用六天 Live RL 训练,给 MiMo-V2.6 做了一场不太像传统发布会的公开亮相。
官方没有只端出一张最终榜单,而是把强化学习训练过程持续展示出来。等训练结束,MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index 上拿到 46 分,超过 Kimi K3 和 Qwen3.8 Max,成为小米所称的“当前最强开源模型”。
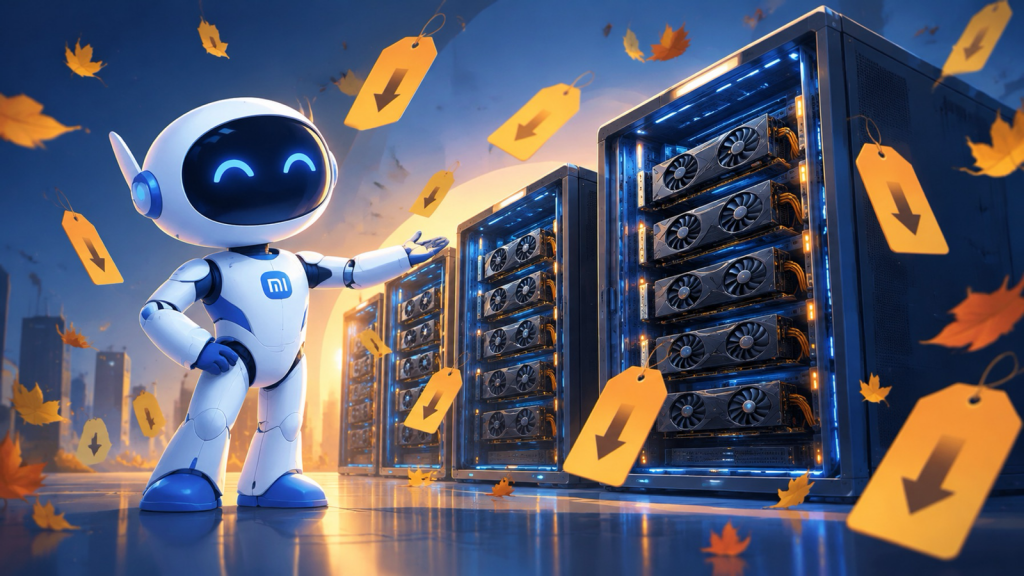
比排名更值得看的是两个同时出现的数字:能力升到 46 分,API 价格却沿用 V2.5。官方给出的说法是,在同等智能水平下,MiMo-V2.6-Pro 的价格约为海外模型的 1/20 至 1/60。它没有证明开源已经全面超过闭源,却把“高水平模型必须昂贵”这个默认前提又往下推了一截。
公开训练也让这次发布多了一层可验证性。榜单只能告诉人们结果,训练过程、技术报告、模型权重和配套 RL 资源则让研究者有机会追问结果从何而来。对于过去常被“PPT 模型”质疑的行业来说,这种把过程和结果放在一起的发布方式,比单独展示几个漂亮分数更有说服力。
先把事情说清楚。这次发出来的是 MiMo-V2.6 系列,两个原生全模态模型,一个叫 Pro,一个叫 Flash。原生全模态的意思是文本、图像、语音这几个通道从预训练阶段就是一起走的,不是后来外挂上去的适配器。真正拿到 46 分的是 Pro 那个尺寸,它现在是开源阵营里综合智能指数最高的那一个。Flash 定位是走量的小尺寸,同价位对手里也不吃亏,主要卖点是又便宜又快。发榜信息来自小米官方文档,快科技当晚也做了整理和转载,想核对细节可以直接翻过去看。
小米在发榜稿里也留了一句重要限定:与 Claude Fable 5.1 和 GPT-6 Astra 等最强闭源模型相比,MiMo-V2.6 仍有差距。现在的格局不是开源全面反超闭源,而是开源模型一边逼近头部,一边继续压低使用成本。
真正值得讨论的,正是这种能力与价格同时变化的经济学。
快科技报道中提到,V2.6 沿用 V2.5 定价,Flash 的缓存命中价格为 0.02 元,Pro 为 0.025 元;具体计价单位和适用条件仍应以小米开放平台的实时价格表为准。原稿若把这两个数字直接理解成“每次调用”,再推导一元钱能调用多少次,就会把不同 token 量、缓存状态和输入输出计价混在一起,结论并不成立。
但方向没有因此改变:当同等能力对应的 token 成本持续下降,单纯靠“少调几次模型”建立的产品价值会变薄。开发者依然要做缓存、限流和成本监控,只是这些更像基本功,而不再天然构成一条护城河。
同一天上线的还有 MiMo Desktop 桌面客户端,附带一个叫 UltraSpeed 的超高速模式,官方说最高 20 倍推理速度。对普通用户来说这是个订阅入口:交个会员费,Pro 和 Flash 随便用;不想订阅,还可以自己接 API Key。这套组合拳其实很老实,它在告诉所有人:小米现在既做发动机,也做整车,两头都想吃。
UltraSpeed 的“最高 20 倍推理速度”是官方公布的上限,不等于每个任务、每个时段都能稳定达到 20 倍,也不能替代独立实测。不过它指向的产品逻辑很清楚:当等待时间明显缩短,用户更愿意把模型用于高频的小任务,而不是只在少数复杂问题上调用一次。
这里藏着一个不那么明显的判断:模型价格降下来只是第一步,响应时间同步压下去,才可能让 AI 变成日用工具。便宜但慢,用户仍会把它当成偶尔使用的服务;便宜又快,才有机会进入翻译、改稿、检索和日常问答这些连续工作流。MiMo Desktop 与 UltraSpeed 的组合,就是在争夺这个高频入口。
表面上看,这只是又一次开源模型能力升级。把官方文档中的定价、开放平台和桌面客户端放在一起看,变化更接近“智能”这件事的经济学被重新计算。
一年前你要用最好的模型,只有两个选项:要么给 OpenAI 或者 Anthropic 交钱,要么用一个能力弱一档的开源模型自己部署,两头都不便宜。现在小米把开源阵营的第一名和白菜价这两件事同时放在你面前。你要用最好的开源模型,价格比自己搭一台带卡的服务器还低,还不用管运维。
这就是所谓智能被打成大宗商品的样子。以前电力刚出来的时候,谁家里有发电机谁家就先进;等到电网铺开,家家有电,「能用电」这件事本身不再是差异化,差异化变成了「你用电做出了什么」。AI 现在到了类似的拐点。基础智能这一层,正在变成谁都能接、按调用付费、便宜到几乎不用管的公共资源。谁做出来的、跑在谁家机房里,反倒是越来越不重要的问题。
对做产品的人来说,这有两种解读,都成立。
第一种解读,这是成本红利,来得正好。以前不敢开的功能可以开了,以前不敢让用户随便调的模型可以敞开用了,以前需要精心设计 prompt 缓存的地方可以粗放一点了。一个原来跑不通账的 idea,可能在今天的定价下能跑通。做 to C 应用的独立开发者尤其应该高兴,模型成本已经不再是主要门槛,你能不能想清楚一个用户真正愿意为之付费的场景才是。原来一天两块钱都心疼的东西,现在可以放开手做几个原型出来玩,玩完再决定哪一个值得认真做。
第二种解读,护城河正在被冲掉。如果你原来的产品,核心竞争力是「我接了一个很贵的模型」,或者「我把模型用得比别人省」,那这两条护城河正在同时消失。前者消失,是因为对手也能接一样贵、甚至更强、更便宜的模型;后者消失,是因为不值得再省。剩下能守得住的,只有你在模型之外做的那部分:数据、场景理解、交付方式、用户关系、品牌。
这两种解读放在一起看,结论其实很清楚:这一轮小米发榜的真正影响,不在小米自己能吃到多少市场份额,而在于它把整个中文 AI 产品圈子的竞争维度往前推了一格。以前大家还在比「谁接的模型更强」,接下来会开始比「你用同样的模型做出了什么别人做不出的东西」。
对依靠模型 API 差价生存的产品来说,问题已经不只是“要不要切 MiMo”,而是模型越来越便宜之后,利润该由什么支撑。一条路是把重心从 API 中间层挪到具体行业数据,另一条路是重做用户交互和交付流程。两条路的共同点,都是不再把“接入模型”本身当卖点,而是把模型当成水电一样的基础投入。
回过头看小米这次的姿态,其实也挺清晰。它不只是在告诉市场“我做了一个很强的开源模型”,还在把模型、开放平台和桌面客户端接成一条普通用户能进入的路径。前者是技术能力,后者是消费产品能力。小米本来就擅长后者,这条路线并不意外。
再往前看一步,有两种合理推演。一是闭源厂商继续下调 API 价格,或者推出更便宜的模型档位,留住不想迁移的客户;二是开源阵营在能力、速度和价格上加快竞争。它们是否会在几个月内发生还不能当作事实,但 MiMo-V2.6 同时提高能力和压低成本,确实给竞争者增加了压力。
还有一个更隐蔽的连锁反应,是关于个人开发者创业窗口的。过去两年做 AI 应用的独立开发者里,混得最累的往往不是产品做得不好的那批人,是产品做得太好的那批人。用户量一起来,API 账单就爆表,涨价用户跑掉,不涨价自己贴钱。做得好和活得下去是矛盾的。这个矛盾在过去主要靠融资去缓冲,现在 46 分开源加 0.02 元 Flash 摆出来,缓冲被换掉了:你可以直接把成本压到能自己养活自己的位置,然后有没有耐心慢慢做,就变成了个人选择而不是资金问题。这对靠自己一个人做产品的开发者是真正的松绑。以前算不过来账的 idea,可以重新拿出来算一遍。
这会让一批过去因模型成本过高而搁置的原型值得重新核算。语言学习、批量内容处理、客服质检等高频场景,不能仅凭宣传价格就判断一定能盈利,但可以拿自己的真实 token 用量、缓存命中率和并发需求做一次小规模压测。账算得通再扩大,远比依据一个最低价格数字直接迁移更稳妥。
还有一个层面是关于国产开源本身的信心问题。过去两年中文开发者用国产模型的心态多少是有点分裂的:一边知道成本上有优势,一边又担心「万一以后哪天出问题了怎么办」。这次 46 分是一次挺关键的心态转折,它让「用国产是不是够用」这个问题的答案,从「勉强能用」变成了「顶级开源就是它」。信心这个东西一旦转过来,很多决策就顺了。企业客户敢把关键业务切过来,独立开发者敢把长期项目押上去,投资人敢投在这条链路上做应用层的团队。46 分不只是个技术分数,它顺带把整条中文 AI 应用链路的心理阻力削掉了一层。
作为普通用户,这一切最直接的好处,就是接下来你在国产 AI 应用里的等待时间会更短,价格会更低,选择会更多。作为做产品的人,最好的动作不是急着切模型,而是花一个下午认真想一件事:如果模型明天再降一半价,我的产品还有什么理由存在?想得清楚的那部分,就是接下来一年里真正能守得住的东西。想不清楚的话,切模型也救不了。
46 分只是一个数字。0.02 元也只是一个价格。这两个数字一起出现的时候,它们在说的其实是同一件事:智能不再稀缺了,稀缺的是你拿它去做什么。
延伸阅读
- 开源基础设施正在吞噬云:OpenTofu、Airbyte 和后厂商锁定时代
- Fivetran vs Airbyte:2026 年数据集成到底该选托管方案还是开源方案?
- 能力、性格、价格:AI 的不可能三角,2026 年你只能选两个
Stay updated with our latest AI insights