一个做 RAG 问答系统的工程师曾经跟我描述过这样一个场景:他们的系统每次响应都要带着一段五千字的知识库摘要作为系统 prompt,用户问第一个问题时首字延迟还算正常,问第二个、第三个之后,整个推理服务开始变得迟钝,GPU 内存告警灯亮起,运维群里开始出现 @ 所有人的消息。
他们当时用的是 vLLM,已经是业界公认最成熟的推理引擎之一。那为什么还是卡?
问题出在 KV Cache 的边界上。
vLLM 的 PagedAttention:把显存当内存管理
PagedAttention 的灵感来自操作系统的虚拟内存分页机制。传统做法里,为一个请求预分配的 KV Cache 空间必须是连续的,但实际使用中 sequence 长度难以预测,预分配过多造成浪费,预分配过少又要频繁扩容。
vLLM 把 KV Cache 切成固定大小的”页”(block),每个 block 存放若干 token 的 KV 数据,不同请求可以共享同一个 physical block(比如公共前缀),block 的分配和回收由 block manager 统一调度。这套机制把显存碎片率压缩到极低水平,也让 vLLM 在并发吞吐量上远超早期推理框架。
PagedAttention 解决的是单个推理引擎内部的显存利用率问题。一次请求进来,KV 数据在显存里缓存,这次请求结束,block 被标记为可回收。下一个请求,哪怕问的是完全相同的问题、带着完全相同的系统 prompt,整个 prefill 阶段还是要重新跑一遍。
这是 vLLM 的设计边界,不是缺陷。它管理的是请求生命周期内的 KV Cache,跨请求复用不在它的职责范围内。
对于无状态 API 服务,这个边界完全够用。但对于多轮对话、长系统 prompt 复用、大规模 RAG 这类场景,每次都重新 prefill 就成了真正的性能瓶颈。
这正是 LMCache 要解决的问题。
—
LMCache:在 vLLM 之外建一层 KV 缓存
LMCache 的定位很清晰:它不替代 vLLM,而是在 vLLM 之上加了一层跨请求的 KV Cache 复用机制。
在 GitHub 上,LMCache 的仓库地址是 https://github.com/LMCache/LMCache,目前收获了约一万两千颗星,对于一个推理加速工具来说这个关注度相当高,说明有大量工程师面对同样的痛点。
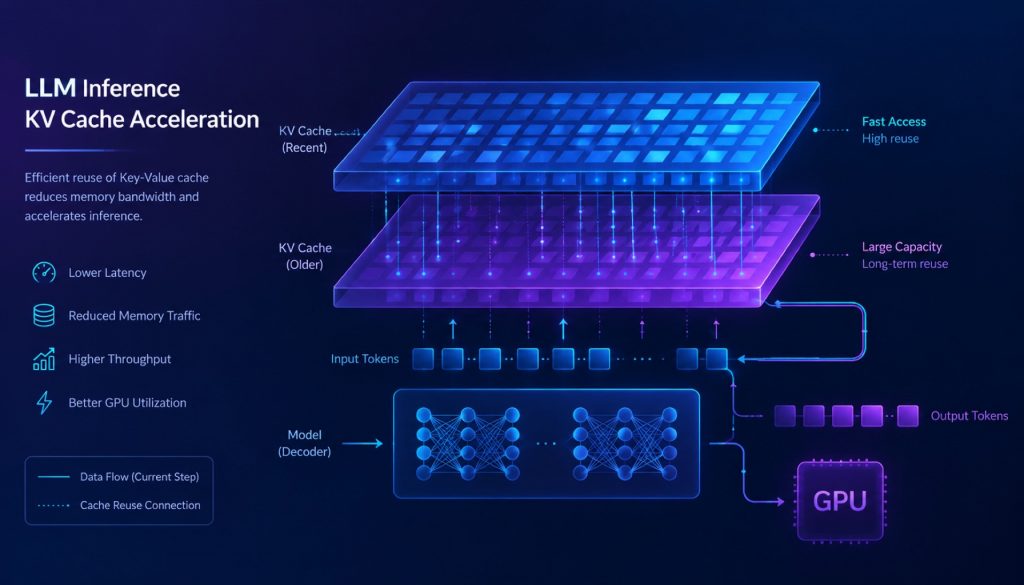
LMCache 的核心思路是:把已经计算好的 KV Cache 序列化存储到更便宜的存储介质上,下次遇到相同(或相同前缀的)输入时,直接从存储中恢复 KV 数据,跳过整个 prefill 计算。
存储层有三个选项:
- CPU 内存:延迟最低,但空间仍然受限
- 本地磁盘(NVMe SSD):容量大,读写速度在现代 NVMe 上足够实用
- 远端存储(Redis 或分布式存储):适合多实例共享缓存,比如多个推理节点服务同一批用户
这三层构成了一个完整的 KV Cache 存储层级,可以根据访问频率和容量需求灵活配置。
从架构上看,LMCache 的工作流程大致是:请求进入时,LMCache 先查询缓存,找到命中的最长前缀,把对应的 KV 数据恢复到 GPU 显存,然后把剩余未命中的部分交给 vLLM 做 prefill。整个过程对上层应用透明,接口保持和 vLLM 兼容。
—
两者的关系:不是竞争,而是分层
一个常见的误解是把 LMCache 和 vLLM 放在同一层级上比较,认为选了 LMCache 就不用 vLLM 了。实际上正好相反。LMCache 依赖 vLLM 作为底层推理引擎,两者是协作关系,不是替代关系。
类比一下:vLLM 是数据库引擎,负责实际的计算执行;LMCache 是查询缓存层,负责在引擎前面拦截可以命中缓存的请求。没有数据库引擎,缓存层没有意义;但有了缓存层之后,很多重复计算就不需要打到引擎上了。
下面这张表整理了两者的主要差异,方便快速定位各自的适用边界:
| 维度 | vLLM(PagedAttention) | LMCache |
|---|---|---|
| 作用层 | 单次请求内的 KV 显存管理 | 跨请求的 KV 缓存复用 |
| 缓存生命周期 | 请求结束即回收 | 持久化,可跨请求/跨实例复用 |
| 存储位置 | GPU 显存 | CPU 内存 / SSD / 远端存储 |
| 依赖关系 | 独立推理引擎 | 依赖 vLLM(或兼容引擎) |
| 适用场景 | 通用 LLM 推理服务 | 长 prompt 复用、多轮对话、RAG |
| 部署复杂度 | 低 | 中等(需配置缓存后端) |
| 额外内存开销 | 无 | 有(CPU 内存或磁盘缓存空间) |
—
实际场景:加速在哪里发生
多轮对话
多轮对话是最直观的受益场景。用户和模型聊了十几轮之后,对话历史累积到几千 token,每次追问都需要把完整历史带进去做 prefill。
用 vLLM 原生机制,每次请求都是独立的,历史 KV 不会被保留。LMCache 把对话历史的 KV 缓存下来,下次请求时直接恢复,只需要对新增的几个 token 做增量 prefill。轮次越多,对话越长,节省的计算越多,TTFT(首字延迟)的改善也越明显。
长系统 Prompt
文章开头那个 RAG 工程师的问题就属于这类场景。如果系统 prompt 是固定的,或者每次请求只在末尾追加用户输入,那么系统 prompt 对应的 KV 只需要计算一次,之后所有请求都可以复用这份缓存。
vLLM 本身对相同前缀有一定的 prefix caching 机制(radix attention),但这个缓存仅在显存中保持,容量有限,并发量大时会频繁被淘汰。LMCache 把溢出的缓存 offload 到 CPU 内存或磁盘,相当于扩大了可用缓存池的体积。
RAG 场景
RAG 架构里,检索出来的文档片段往往在多个用户的不同查询中被反复命中。这些文档片段对应的 KV,如果能跨用户共享,就能避免大量重复的 prefill 计算。
这是 LMCache 远端存储模式最有价值的地方。把缓存放在 Redis 上,多个推理实例共享同一份热门文档的 KV 数据,不仅减少计算,还减少了每个实例的显存压力。
—
部署复杂度和工程代价
任何加速方案都有代价,LMCache 也不例外。
存储开销:KV Cache 的体积本身就很大,序列化存到 CPU 内存或磁盘之后占用的空间同样可观。一个长期运行的服务需要设计缓存淘汰策略,否则存储会无限增长。
序列化延迟:把 KV 数据从 GPU 搬到 CPU 再写到磁盘,这个 IO 过程有延迟。对于低并发场景,如果缓存命中率不高,这个开销可能反而拖慢响应速度。
缓存一致性:如果同一个模型有多个版本在线(比如 fine-tune 更新),旧版本的 KV Cache 对新版本来说是无效的,需要管理缓存的版本对应关系。
运维复杂度:引入 Redis 或分布式存储后,整个推理链路多了一个外部依赖,故障点也随之增加。
对于单机部署、并发量不高、prompt 相似度低的场景,这些代价的收益比并不划算,直接用 vLLM 原生机制更简单。
—
什么时候用 vLLM 原生就够
vLLM 的 prefix caching 已经覆盖了相当一部分常见场景。如果:
- 系统 prompt 固定且较短(几百 token 以内)
- 并发量适中,GPU 显存够用
- 不需要跨实例共享缓存
- 场景是一次性查询为主,多轮对话比例低
那么 vLLM 的原生机制完全够用,不需要引入 LMCache 增加系统复杂度。
反过来,以下情况下 LMCache 的收益会更明显:
长 prompt 高度复用:几千 token 的系统 prompt 在大量请求中共享,每次 prefill 的算力浪费非常突出。LMCache 把这部分 KV 持久化后,命中时 TTFT 能有显著下降。
多轮长对话:对话历史超过 2K token,且用户会话持续时间较长,跨轮次的 KV 复用价值很高。
多实例 RAG 服务:同一批文档被多个推理节点反复编码,远端共享缓存能减少整体计算量和显存压力。
显存极度紧张:GPU 显存不足以同时缓存多个长序列时,把低频 KV offload 到 CPU 内存或 SSD,相当于变相扩充了缓存池。
—
回到那个工程师
文章开头的工程师后来怎么做的?
他们在 vLLM 之上接入了 LMCache,把那段固定的五千字知识库摘要对应的 KV 持久化到 CPU 内存里。之后每次请求到来,只需要对用户的实际问题做少量 prefill,系统 prompt 部分直接从缓存恢复。首字延迟明显改善,GPU 告警也不再频繁出现。
代价是多了一套缓存管理逻辑,以及一些额外的 CPU 内存占用。但对于他们的场景来说,这是值得的。
LMCache 和 vLLM 的关系,本质上是工程里一个反复出现的模式:有一个做得很好的通用工具,然后有人在上面加了一层针对特定痛点的优化。这个优化不会让通用工具变得多余,只是让它在某些极端场景下走得更远。
选哪个,取决于你的系统在哪里卡住。
延伸阅读
- LLM 推理成本正在崩塌:当 AI 几乎免费,游戏规则怎么变?
- AI 推理平台怎么选:Modal vs Replicate vs Baseten vs RunPod,2026 年谁更适合你跑模型?
- LLM 网关怎么选:Portkey vs LiteLLM vs OpenRouter vs Helicone,2026 谁更适合你的 AI 应用?
- 端侧 AI 正在偷袭云端:2026 年苹果、高通、AMD 凭什么把 LLM 塞进你的口袋
Stay updated with our latest AI insights