有一类 bug,专门出现在凌晨。
你在调试一个 AI agent,任务很简单:让它登录某个 SaaS 后台,抓取上个月的账单数据。Playwright 脚本跑了两周没出问题,某天突然开始报 timeout。不是网络问题,也不是选择器失效,而是页面加载顺序变了,按钮出现的时机提前了 200 毫秒。
这个 bug 你花了三个小时才找到。不是因为它多难,而是因为 Playwright 告诉你的只有”TimeoutError: waiting for selector”,它不知道你在做什么,它只知道你让它等一个 CSS 类名。
这就是用通用浏览器自动化工具搭 AI agent 的本质问题:工具的设计假设和你的使用场景错位了。
工具是为谁设计的
Playwright 发布于 2020 年,解决的是端对端测试和 RPA 的问题。它的 API 是面向人类操作逻辑的:点击、填表、等待、断言,每一步都对应一个明确的 DOM 动作,开发者写代码时心里有完整的页面蓝图。
这套设计在测试场景里非常好用。页面结构固定,操作路径可预期,就算偶尔有 flaky test 也能靠重试解决。
但 AI agent 的工作方式不一样。
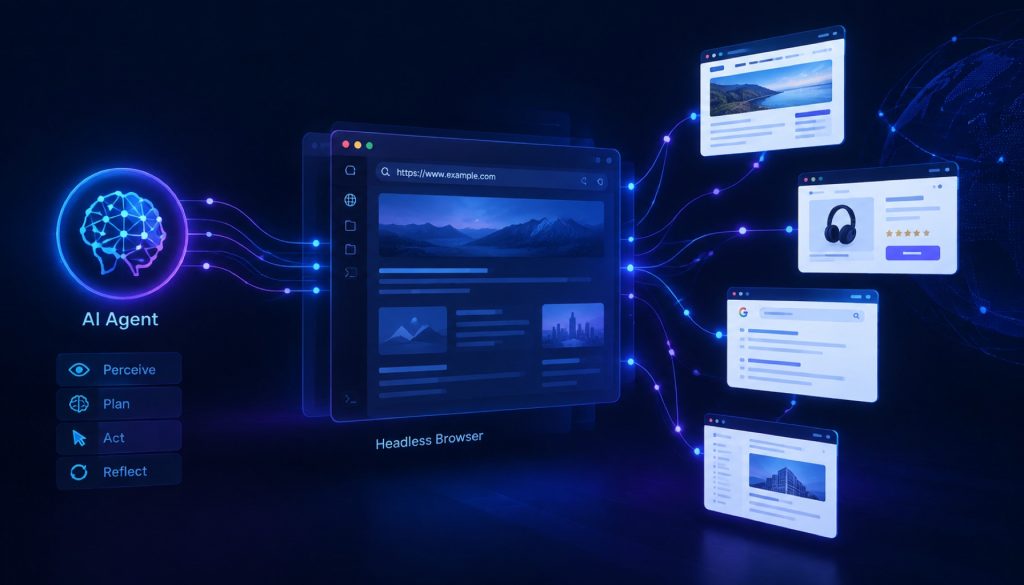
一个典型的 LLM agent 在执行浏览器任务时,并不事先知道完整的页面结构。它接到指令,生成一个行动,执行,观察结果,再决定下一步。这是一个反馈循环,不是一个脚本。每次行动都需要浏览器给出”现在页面是什么状态”,而不只是”这个元素有没有出现”。
当你用 Playwright 给 agent 提供浏览器能力时,你需要自己实现这个观察层:把页面内容序列化成 agent 能理解的格式,处理截图与文本的对齐,管理 session 上下文,还要解决 LLM 输出的行动指令和 DOM 操作之间的翻译问题。这些工作不复杂,但加起来是相当大的胶水代码量,而且每个 agent 框架的集成方式都不一样。
大约从 2025 年底开始,专门为这个场景设计的工具开始陆续出现。Obscura 是其中一个。
Obscura 在做什么
Obscura(obscura.sh)的出发点是:把”浏览器操作”这件事的接口重新设计,让 LLM agent 能直接使用,而不需要额外的翻译层。
从 GitHub 上的文档和实现来看,它的核心思路有几处值得拆开说。
首先是行动原语(action primitive)的抽象层级。传统工具给你的是 click("#submit-btn"),Obscura 给你的是更接近意图表达的操作接口,agent 可以传递”点击提交按钮”这类语义描述,工具自己处理定位和执行。这意味着 agent 不需要事先知道按钮的选择器。
其次是观察接口的设计。浏览器在执行每个动作后,会返回一个结构化的页面状态描述,包括可交互元素、当前 URL、页面主要内容等。这个格式是为 LLM 消费优化的,不是原始 HTML,也不是截图(截图的 token 消耗高得多)。
第三是 session 管理。agent 任务往往需要跨多个步骤维持登录状态,Obscura 在这方面提供了原生支持,不需要每次手动序列化 cookies。
它目前是开源项目(MIT 授权),可以本地部署,据报道在与 LangChain、AutoGen 等框架的集成上有现成适配,减少了接入的胶水代码。
当然,28000 多颗星的 GitHub 项目不等于生产可用。它仍然是一个相对年轻的工具,社区规模和稳定性都不能和 Playwright 比。选它意味着你接受一定的早期采用者风险。
市场上还有哪些选择
理解 Obscura 的位置,需要先看清楚整个工具谱系。
Playwright 是目前最主流的无头浏览器工具,微软出品,跨 Chromium、Firefox、WebKit 三个引擎,API 设计成熟,社区文档丰富。它的问题前面说了:设计假设是脚本驱动的确定性操作,不是 agent 的观察-行动循环。用它搭 agent 不是不行,但你需要自己处理大量中间层。如果你的 agent 任务路径高度固定,几乎不需要动态决策,Playwright 仍然是合理选择,因为它足够稳定可靠。
Puppeteer 是 Google 推出的 Chrome 自动化工具,功能上比 Playwright 窄(只支持 Chrome/Chromium),API 风格类似。在 Playwright 出现后,Puppeteer 的使用场景已经基本被覆盖,新项目很少会优先选它,除非有特殊的 Chrome DevTools Protocol 需求。
Browserbase 走的是完全不同的路线:云端托管的 headless browser 服务,专门针对 AI agent 场景设计。你不需要管理浏览器实例的生命周期,按需调用即可。它提供了 session 录制、断点重放、并发扩展等功能,对于需要大规模运行 agent 任务的场景(比如批量数据采集、自动化测试流水线)有明显优势。代价是它是商业服务,有使用成本,数据流经第三方服务器,需要考虑合规问题。
Stagehand 是 Browserbase 团队开源的高层框架,建在 Playwright 之上,提供了更贴近 LLM 使用习惯的 API(act、extract、observe 三个核心方法)。它的设计目标和 Obscura 有重叠,都是降低 agent 接入浏览器的门槛,但实现路径不同:Stagehand 是在 Playwright 上加一层,Obscura 是从底层重新设计。Stagehand 背靠成熟的 Playwright 基础,稳定性更有保障;多了一层抽象的代价是调试时更难定位到具体的浏览器行为。
以下是几个工具的核心特征对比:
| 工具 | 设计定位 | 部署方式 | 开源授权 | LLM 集成难度 |
|---|---|---|---|---|
| Playwright | 通用自动化/测试 | 本地 | Apache 2.0 | 高(需自建中间层) |
| Puppeteer | Chrome 自动化 | 本地 | MIT | 高(同上) |
| Browserbase | AI agent 专用 | 云端托管 | 商业服务 | 低(原生支持) |
| Stagehand | AI agent 高层框架 | 本地/云端 | MIT | 低(内置适配) |
| Obscura | AI agent 专用 | 本地 | MIT | 低(原生设计) |
表格里”LLM 集成难度”这列是相对判断,不是绝对门槛。用 Playwright 接 LangChain 完全可以做到,只是需要写更多代码。
怎么选
先确认你的任务类型。
如果你的浏览器任务路径高度固定,操作序列可以提前写死,Playwright 是最安全的选择。它有最好的文档、最大的社区、最多的 Stack Overflow 答案,出了问题容易找到解法。
如果你需要 agent 做真正的动态决策,页面结构未知、操作路径依赖中间结果、需要处理意外情况,那应该认真考虑 AI-native 工具。这时候 Stagehand 是风险最低的起点:它基于 Playwright,稳定性有保障,上手成本低,Browserbase 团队持续维护。
如果你需要大规模并发运行 agent 任务,不想自己管浏览器基础设施,Browserbase 的托管服务值得评估。把运维成本算进去,商业服务的性价比可能比自建更合理。
Obscura 适合的场景更具体:你想要本地部署、MIT 授权、不依赖商业服务,同时又不想写大量胶水代码,愿意接受一个相对年轻的工具带来的不确定性。如果你正在从头搭建一个 AI agent 项目,Obscura 值得作为候选之一做一次 spike,看看它的 API 风格是否适合你的 agent 架构。
有一点要说:选工具不是终点,维护才是。无头浏览器工具面对的目标网站在持续更新,反爬策略在演进,agent 的任务需求也在变。选一个有活跃维护的工具,比选一个功能更丰富但已经半死不活的工具,往往更重要。
延伸阅读
- Contentful 替代品推荐:2026 年最好用的 5 个 Headless CMS
- Flipbook 爆火背后:AI 正在让网页本身消失
- Stagehand 不够用了?2026 年浏览器自动化替代方案实测
Stay updated with our latest AI insights