设想这样一个周一早上九点,做家居独立站的老陈打开表格,发现三家竞品的价格列全是空的。脚本没报错,日志里一排 200,抓回来的内容是一句“该商品已下架”。他花了一个上午翻代码,才确认对方把价格从 span.price 挪进了一个带哈希后缀的 div。改完上线,第三周,另一家竞品换了前端框架,同样的活儿又做了一遍。
做电商运营、市场调研、招聘聚合的人,大概都经历过这种循环。网页是给人看的,接口是给程序用的,中间这层转换没有标准答案,也没有一劳永逸的写法。手写爬虫的麻烦不在于难,而在于它把“页面长什么样”当成了前提。页面一变,前提就没了。
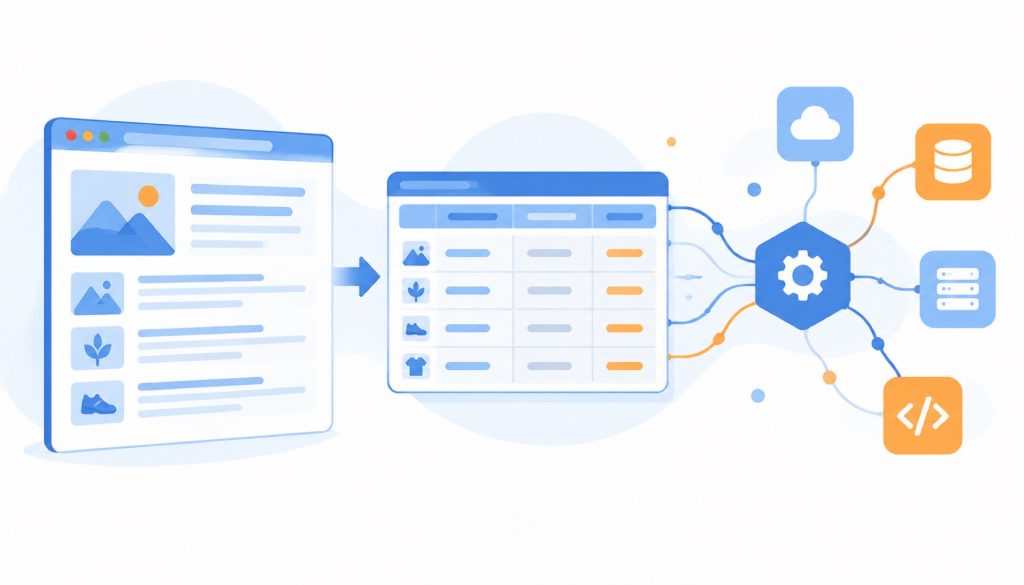
过去两年,一类工具专门来处理这件事:把任意网页变成结构化数据,再包成 API 或者一张表。Maxun 是其中比较有代表性的一个,AGPLv3 开源,GitHub 上接近 1.8 万 star(https://github.com/getmaxun/maxun),官网是 https://www.maxun.dev 。它把抓取拆成五种动作:Scrape 把单页转成 Markdown、HTML、纯文本或截图,Crawl 顺着链接爬整站,Extract 把列表和表格抽成行列,Search 按关键词找页面再抓,Monitor 定时跑并在内容变化时通知。用法有三条路:在录制器里点选元素,用一句自然语言描述你要什么让 AI 模式去找,或者直接调 API、SDK、CLI、MCP。
不过真到要选的时候,问题很少是“Maxun 好不好用”,更多是“我的情况适合它,还是适合别人”。
先把问题拆开:你要抓一次,还是养一条管道
偶尔抓一次数据,用什么工具都行,复制粘贴也能凑合。真正难的是每天都要,而且要得准。这时候决定成败的往往不是抓取能力本身,是四件很朴素的事。
数据放在哪。有些公司的合规要求数据不出内网,那就只能自托管。Maxun 的仓库里给了 Docker Compose 和本地安装两条路,自托管版本包含 scrape、crawl、extract、search、监控、API、SDK、webhook 和登录态抓取。云版额外提供托管的反爬基础设施、代理轮换、验证码处理、列表页跟进详情页的深度抓取,以及页面改版后的自动适配。这个差别值得提前看清楚,因为“开源版能跑”和“开源版能扛住反爬”是两件事。
谁来维护。运营自己用,界面友好度比 API 设计重要。工程团队接进数据管道,返回格式、错误码、限流策略比按钮好不好看重要。
页面变了怎么办。有的工具靠选择器,改版就断;有的工具靠视觉或语义定位,容错高一些但结果不够确定;Maxun 官方说法是检测到结构变化后会自动调整机器人,云版才有这项能力。
钱怎么算。这一类工具的定价普遍按 credits 或者按结果条数走,看起来单价都很低,真正的差别在失败重试算不算钱、代理流量怎么计、并发要不要加钱。
把这四件事想清楚,再看工具,判断会快很多。
七个选择,放在同一张桌子上
下面这张表只比六件会影响长期使用的事:授权协议、能不能自托管、钱怎么算、要不要写代码、动态页面和登录态怎么处理、以及它大致适合谁。没有比 star 数,也没有比功能列表的长度,那些东西和三个月后你会不会想换掉它关系不大。
| 工具 | 授权协议 | 部署方式 | 定价模式 | 是否需要写代码 | 动态页面与登录态 | 适合谁 |
|---|---|---|---|---|---|---|
| Maxun | AGPLv3 开源 | 自托管(Docker 或本地)+云服务 | 云版按 credits,只对成功请求计费,7 天试用;自托管免费 | 三者都行:录制、自然语言、API/SDK/CLI/MCP | 真实浏览器渲染;登录态用 Chrome 扩展复用已登录会话 | 既想让运营自己建机器人,又想让开发接 API 的团队 |
| Firecrawl | AGPL-3.0 开源 | 自托管+云服务 | 免费 1,000 credits/月;Hobby 19 美元/月含 5,000 credits;Standard 83 美元/月含 10 万 credits(按年付) | 以 API 为主,需要写代码调用 | 以抓取和搜索接口为核心;登录态以官网为准 | 给 AI 应用、RAG 管道喂网页内容的开发者 |
| Crawl4AI | Apache 2.0 | 自托管(pip、Docker、CLI)+云服务 | 自托管免费;云版每月 1,000 免费 credits,付费从 10 美元/月起 | 需要写 Python,或用 CLI、REST 接口 | Playwright 渲染;支持持久化浏览器配置,可保留登录状态 | 想把抓取写进自己代码里的 Python 团队 |
| ScrapeGraphAI | MIT | 自托管 Python 库+托管 API | 自托管只花 LLM 和服务器成本;云 API 按 credits,价格以官网为准 | 需要写 Python,或者用它的云 API | 浏览器渲染由 Playwright 配置;登录态以官网为准 | 愿意用大模型理解页面、不想维护选择器的人 |
| Apify | 商业闭源 | 云平台为主,也有开源 SDK 和本地运行方式 | 免费版每月 5 美元平台额度;Starter 19 美元、Scale 199 美元、Business 999 美元;Actor 另按事件或用量计费 | 现成 Actor 不用写代码;定制要写 JavaScript 或 Python | 平台内置代理与浏览器,具体看所用 Actor | 需要大量现成采集脚本、按需组合的人 |
| Browse AI | 商业闭源 | 纯云服务 | 免费版 2 个网站;Personal 48 美元/月(年付 19 美元/月);Professional 87 美元/月(年付 69 美元/月);Premium 500 美元/月起 | 不需要写代码,浏览器扩展录制 | 云端浏览器,支持登录录制、代理和验证码处理 | 完全不想碰代码的运营、销售和调研人员 |
| Octoparse | 商业闭源 | 桌面客户端+云采集 | 免费版 10 个任务、本地运行;付费从 69 美元/月起 | 不需要写代码,点选式配置 | 客户端内置浏览器;登录相关配置以官网为准 | 习惯桌面软件、任务量不大的个人和小团队 |
表格能说明的是结构,说明不了手感。同样是“不需要写代码”,录制器的容错能力差很多;同样写“按 credits 计费”,失败一次算不算钱、代理流量单独收不收,月底账单会告诉你答案。所以下面这些具体的场景,比表格更值得花时间看。
Maxun 自己:录制和 API 之间没有墙
有家做宠物用品的小公司,两个人,一个管运营一个写代码。运营要盯五个竞品的价格和库存,开发不想为五个站点各写一套解析逻辑。他们最后的分工是这样的:运营在 Maxun 的录制器里把每个站点的商品名、价格、库存点一遍,设成每天早上跑;开发拿机器人 ID 调 API,把 JSON 拉进自己的数据库,再和自家的定价规则做比对。中间没有导表格,也没有人肉同步。
这个流程之所以成立,是因为录制和接口指向同一个机器人。很多工具在这件事上是断开的:界面里配的任务只能在界面里看,要用 API 得另建一套。Maxun 把两种用法放在同一个对象上,改一处两边都生效。对小团队来说,真正省下来的是沟通成本。
它也有需要提前想清楚的地方。自托管要自己管服务器、浏览器和升级,官方给了 Docker Compose 和本地安装两条路,但服务器不会自己变好。云版按 credits 计费,只对成功的请求扣费,套餐上限到每月 35 万 credits,更大的量要单独谈。数据敏感就自托管,怕运维就上云,这个选择没有中间地带。
Firecrawl:把网页变成模型能读的文本
设想一个做知识库的人,目标不是抓价格,是把几十个行业站点的文章喂给检索系统。他需要的不是整齐的表格,而是干净的 Markdown,标题层级清楚,导航和页脚被剔掉。Firecrawl 就是从这个需求长出来的,接口里有 scrape、crawl、map、search、interact、monitor,还有一个叫 agent 的预览功能。
它的仓库同样是 AGPL-3.0(https://github.com/firecrawl/firecrawl),产品官网在 https://www.firecrawl.dev ,也提供了自托管路径,但多数人用的是云服务。定价页写得很细:每月 1,000 免费 credits,Hobby 每月 19 美元给 5,000 credits,Standard 每月 83 美元给 10 万 credits,按年付结算。基础抓取一页一个 credit,搜索每 10 条结果两个 credit,抓取时如果要 JSON 格式,每页再加 4 个 credit。抓取没有返回结果不计费,但页面返回 403 或 404 仍然算一次。这些细节在选型时比“每页多少钱”那句话有用得多。
它适合的人很明确:手上有一个 AI 应用,需要稳定地把网页内容变成模型能吃的文本或 JSON,团队里有开发能接 API。如果需求是让运营每天在界面上点几下生成一张报价表,它不是最顺手的那个。
Crawl4AI:把抓取当成代码的一部分
另一个极端是 Crawl4AI。它是 Python 库,Apache 2.0 协议(https://github.com/unclecode/crawl4ai,官网 https://crawl4ai.com ),装法就两行:pip install -U crawl4ai,再跑一次 crawl4ai-setup 把浏览器装好。之后在代码里 AsyncWebCrawler().arun(url),拿到的 result.markdown 就是整理过的正文。
它解决的问题和 Firecrawl 很像,路线却相反:把控制权全部交给你。浏览器用 Playwright,可以指定 Chromium、Firefox 或 WebKit;可以开持久化配置目录,把登录状态留在本地;可以设代理、改请求头、注入脚本;深爬有广度优先、深度优先和最优先三种策略,长任务还能断点续爬。对需要把抓取嵌进已有数据管道的人来说,这种“什么都能改”比“开箱即用”更重要。
代价也很清楚:页面结构、反爬、代理、并发,全部自己负责。官方也提供了云版,每月 1,000 免费 credits,付费从 10 美元/月起,云端一次流式请求最多 50 个 URL,后台任务可以到 10,000 个。这条产品线的存在其实说明了一件事:自托管免费,但自托管的隐性成本一直在。
ScrapeGraphAI:用一句话代替选择器
设想一个做市场分析的小团队,成员会写一点 Python,但没人愿意维护几十条 XPath。他们的做法可以是给每个站点写一句描述,比如“把这页所有产品的名称、价格、评分取出来”,剩下的交给模型。ScrapeGraphAI 就是为这种用法准备的,MIT 协议(https://github.com/ScrapeGraphAI/Scrapegraph-ai,官网 https://scrapegraphai.com ),核心是一组用图结构串起来的抽取流程,最常用的 SmartScraperGraph 只要一个 prompt 和一个网址。
它的好处是页面改版后,描述通常还成立,坏处是每次抽取都要过一遍模型,成本和速度都受模型影响。本地跑可以用 Ollama,接 OpenAI、Gemini、Groq 也行,key 得自己准备。官方还提供托管 API,按 credits 计费,具体价格以官网为准。
选择它的人,通常已经接受“用模型换维护成本”这笔交易。如果数据要求逐条对得上、错一条都不行,纯选择器方案反而更可控。
Apify:不想从零搭,去商店里挑一个
Apify 的思路更像应用商店。平台上有大量别人写好的 Actor,从社交平台到地图数据,很多常见场景都能直接找一个现成的,填几个参数就能跑(https://apify.com)。定价也是平台式的:免费版每月 5 美元额度,Starter 19 美元,Scale 199 美元,Business 999 美元,计算按 CU 算,1 CU 等于 1GB 内存跑一小时,基础价 0.2 美元。现成 Actor 多数按事件计费,比如每返回一条结果收一次钱;代理单独计费,住宅代理 8 美元/GB 起。
它的强项是覆盖面。冷门站点、社交平台、地图数据,别处要自己啃的地方,这里常常已经有人做完了。弱项是账单的可预测性,一个 Actor 跑起来,计算、代理、结果条数三笔费用叠在一起,不跑一次很难估准。适合那些需求明确、量不小、又不想自己维护采集代码的团队。
Browse AI:不会写代码的人,用录制换稳定
回到开头的老陈(一个设想的场景)。如果他不再修脚本,而是让运营用 Browse AI 录一遍流程:打开竞品页面,点选商品名和价格,设置每天跑一次,结果直接进 Google Sheets。整个过程在浏览器扩展里完成,官方说新用户大约五分钟能建好第一个机器人(https://www.browse.ai)。
这类工具的核心价值,是把抓取变成任何人都能做的动作。代价体现在价格和边界上:免费版只能挂 2 个网站,监控最快每小时一次;Personal 每月 48 美元,年付折到 19 美元;Professional 每月 87 美元,年付 69 美元;再往上是从 500 美元起的管理服务。计费按 credit,一个 credit 抓 10 行,列表 50 个商品就是 5 个 credit,再点进每个详情页又是 50 个。需要代理或验证码的站点会被标为 Premium,单次最少扣 2 到 10 个 credit。
它适合运营、销售、调研这类完全没有工程资源的人。反过来,如果数据要进自己的数据库、要做二次计算、要控制每次请求的细节,用它会很快碰到天花板。
Octoparse:桌面软件那套老办法,但很熟练
Octoparse 是这批工具里资历较老的一类,形态是桌面客户端,操作方式是点选页面元素、设置翻页和循环(https://www.octoparse.com)。免费版能建 10 个任务,在本机跑,导出 Excel、CSV、JSON 都行;付费从每月 69 美元起,云采集、定时任务、API 访问在付费档里。
它的优点是直观,尤其对习惯 Excel 的人,任务结构看得见摸得着,调试也方便。缺点也和桌面软件有关:任务跑在自己电脑上,机器关了就不跑;换人接手要重新讲一遍每个任务是怎么配的;大规模并发要靠云采集,而云采集是另一套计价。代理 3 美元/GB,验证码 1 到 1.5 美元每千次,代建爬虫 399 美元起,这些附加项加起来,实际支出往往高于标价。
怎么选:几种常见处境下的答案
如果团队里既有开发又有运营,两边还要交接,Maxun 的结构是最顺的。运营在界面上录制或者用一句话生成机器人,开发拿同一个机器人的 API 接进系统,不用维护两套东西。愿意自己管服务器就自托管,AGPLv3 对内部使用没有额外约束;不想碰运维就用云版,反爬、代理、改版适配都在云上。需要留意的是,把修改过的代码作为网络服务对外提供时,AGPLv3 要求公开改动,这条对做产品的团队有实际影响,内部使用不受影响。
如果核心需求是给 AI 应用喂内容,抓回来的是文章、文档、知识库页面,Firecrawl 的接口设计和计费方式更贴合,Crawl4AI 则适合把这套能力直接写进 Python 服务里,前者省事,后者省钱。
如果需求是“某个站点的数据,今天就要”,先去 Apify 的商店里搜一下,很可能已经有人写好。如果需求是“我们完全不写代码,只要一张每天更新的表”,Browse AI 和 Octoparse 都能做到,前者在云端、协作和集成上更现代,后者在复杂翻页和本地调试上更老练。
还有一种情况要提前算:量。多数工具的免费额度看着够用,实际跑起来很快见底。一个商品列表页 50 条,五个竞品,每天一次,一个月就是 7,500 条;如果还要点进详情页,数字翻倍。按 credits 计费的工具,这时候要把“每条结果几个 credit”换算成月账单,再和自托管一台服务器的钱比一比。小量的时候云服务明显划算,量大到某个点,自托管开始占优,这个拐点每个团队都不一样。
另外别忘了条款。抓公开数据在很多地方是允许的,但具体要看目标网站的服务条款、数据是不是个人信息、以及你拿它做什么。Maxun 官方在说明里也提到建议逐站核对条款、避免在没有合法依据的情况下处理个人数据,并提供限速以免给网站造成压力。这段话不是法律意见,但方向是对的:工具只负责把数据取回来,怎么用是你的事。
如果需求本身还在变,今天抓价格,下个月想抓评论,再下个月想监控上新,别急着买年付套餐。先用免费额度把流程跑通,看看数据出来之后有没有人真的用。工具换起来不难,难的是把一条没人看的管道维护一年。
老陈这个场景里最朴素的方案是:运营用录制工具维护三个竞品,开发写一个小服务,每天把结果拉进自己的库,改版的时候只改一个机器人的配置。真正的变化不是省了多少时间,是页面再改版的时候,不用在周一早上九点翻代码。
延伸阅读
- AI 网页抓取工具怎么选:Firecrawl vs Apify vs Browse AI vs Diffbot,2026 谁更适合你的数据工作流?
- Postman 替代品推荐:2026 年最好用的 5 个 API 开发工具
- API 开发工具怎么选:Insomnia vs Bruno vs Hoppscotch vs HTTPie,2026 谁更适合你?
- OpenCLI vs page-agent:让 AI Agent 直接操作网页的两条路线(2026)
Stay updated with our latest AI insights